
ローカルのを比べたら、思考モードに切り替えても点数が伸びない。そんなときに確認したいのが、答えを書き終える前に処理を止めていないかです。今回、Gemma 4の原版側と改変版のQ2_K配布物を、日本語の自作課題で比較しました。出力上限を1,024から4,096トークンへ増やし、解ける問題が増えるか、反復が長く続くだけなのかを実測します。
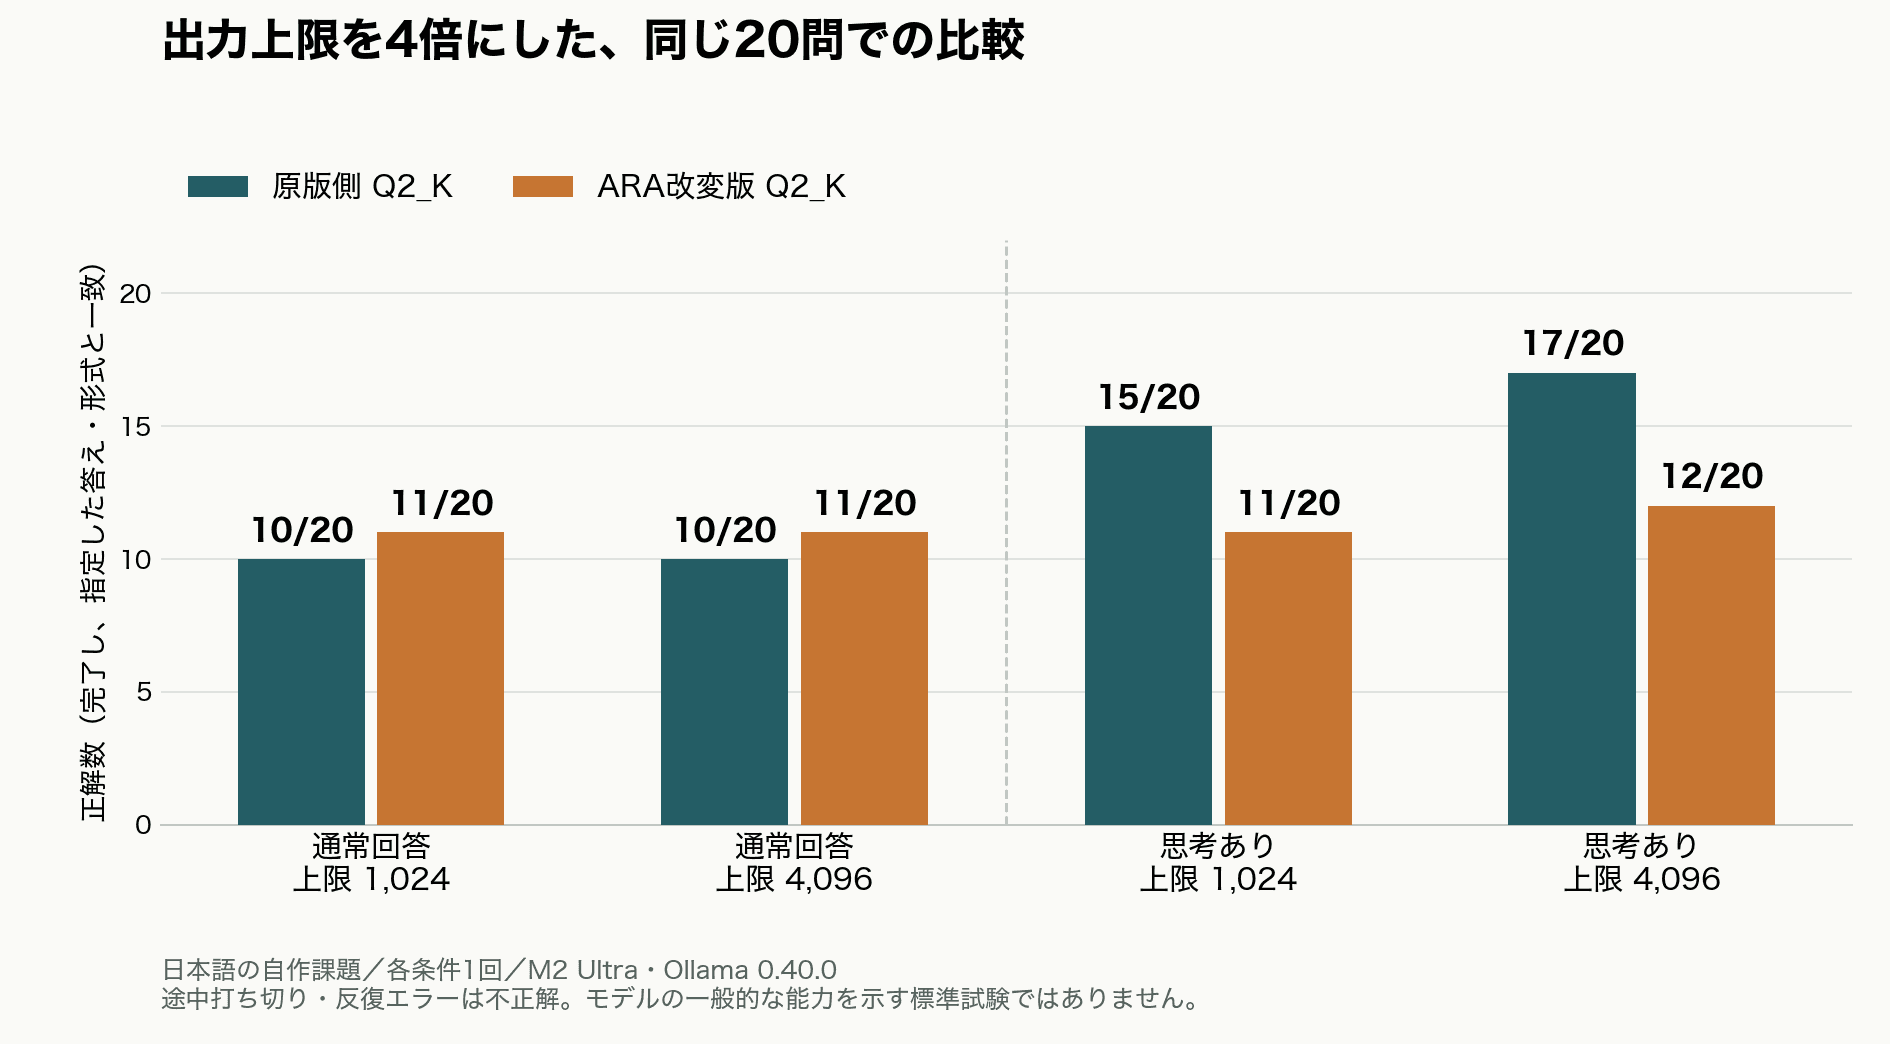
思考ありの正答は、ARA版11/20→12/20、原版側15/20→17/20でした。通常回答はARA版11/20、原版側10/20のままです。思考ありの回答時間合計は約80%・約68%増えました。上限の拡大は一部に効きましたが、反復による未完了も残っています。
この記事で扱うのは、モデルの優劣だけでは説明できない評価条件の問題です。上限を小さくした運用で答えが返らなければ、それは利用者にとって失敗です。一方、その失敗をすべて計算能力や読解能力の不足と呼ぶと、改善すべき設定を見誤ります。回答が間違ったのか、回答を出す前に止まったのかを、記録から分けて調べます。
比較したものは、同じQ2_Kの原版側とARA版
対象は 31Bの原版と、で処理された版です。どちらもで配布される同じ方式のを使いました。前の重みをそのまま動かした比較ではありません。Q2_Kで生じる品質変化も含んだ配布物の比較なので、結果を元モデル全体の性質へ広げることはできません。
原版はmradermacherの配布物、ARA版は対応する改変版の配布物に固定しました。生成を動かすも0.40.0へ固定しています。検証途中でモデルや実行ソフトを更新すると、出力上限を変えた影響と切り分けられなくなるためです。
配布元の上流モデルカードには拒答に関する評価もありますが、今回はその追試ではありません。使ったのは架空の受注、在庫、会議メモ、計算、論理、短いコードの読み取りです。有害な依頼を与える拒答率試験は行わず、生成されたコードも実行していません。 なお、上流カード自身が報告する量子化前の5種ベンチマークの平均差は、原版に対して−2.18ポイントです。本稿の日本語Q2_K試験とは条件が異なるため、今回の点数と混ぜて評価しません。
1024トークンでは、思考の途中で終わる回答があった
先行試験では60問を作り、その実行前に選んだ20問を思考モードでも処理しました。ここでは比較対象を同じ20問へそろえます。コード分野は短い処理の結果を読む問題で、プログラムを新規に作る能力を測ったものではありません。通常モード60問の点数と、思考モード20問の点数をそのまま並べると、問題の難しさと動作モードの違いが混ざるからです。以下は出力上限1024、文脈8192で得られた初回の結果です。
| 同じ20問・上限1024 | 通常モードの正答 | 思考モードの正答 | 思考モードの上限停止 | 思考モードの反復エラー |
|---|---|---|---|---|
| ARA版 | 11/20 | 11/20 | 6件 | 3件 |
| 原版 | 10/20 | 15/20 | 5件 | 0件 |
ここで見落としたくないのは、思考モードで正常に完了した回答は、ARA版11件、原版15件のすべてが正答だったことです。ARA版の残る9件は6件が出力上限、3件が反復による中断。原版の残る5件は出力上限でした。「間違った答えが増えた」と一括りにすると、この内訳が消えてしまいます。
ただし、完了した分だけを取り出して「正答率100%」と宣伝するのも適切ではありません。長い推論が必要な難しい問題ほど未完了になっている可能性があり、完了分は同じ20問を代表しません。利用者へ正しい回答を届けられた割合は、あくまで全20問を分母にした11/20と15/20です。完了分の正しさは、出力枠を増やして確かめる価値があると判断する手掛かりに使います。 また、上限停止の11試行のうち3試行は思考欄が空で、本文側が記号や数字を反復していました。上限に達したことだけでは、考える時間が足りないとは判断できません。
思考と最終回答は、同じ出力枠を使う
は、表示される回答の文字数そのものではありません。文章はという単位へ分けて処理され、今回の実行経路では、の推論文と最後の回答が同じ生成枠を使います。推論に大半を使うと、答えが数文字で済む問題でも、その答えを書き出す前に上限へ達することがあります。
この関係は実装でも確認できます。Ollama 0.40.0は、生成するトークン数を実行エンジンへ渡した後、返ってきた出力を思考と本文へ分離しています。思考を別欄に表示することは、回答用の上限を別に確保することではありません。生成結果を分離する処理を確認すると、この順序が分かります。
出力枠とも分けて考えます。後者は、入力文やそれまでの生成内容を参照するための容量です。大きくするとなどのメモリ使用が増えます。主比較は文脈を8192で固定し、意図的に変える推論設定を出力上限へ絞りました。長い入力まで同時に増やした検証ではありません。
追加試験は同じ20問、上限4096で条件をそろえる
追加試験では、同じ20問を原版・ARA版の通常モード・思考モードでそれぞれ1回ずつ実行しました。出力上限を1024から4096へ増やし、それに合わせて1件の処理時間にも余裕を持たせました。結果を見てから都合のよい問題へ入れ替えず、問題、正解、採点器、設定を実行前に保存しています。
| 項目 | 追加試験の固定条件 |
|---|---|
| 実機 | Apple M2 Ultra、メモリ192GiB、macOS 27.0.1 |
| 実行ソフト | Ollama 0.40.0、GGUFをllama.cppで実行 |
| 問題 | 先行試験と同じ20問、4条件共通 |
| 分野 | 計算・論理・コード読解・情報抽出・資料参照を各4問 |
| モデル | 原版Q2_K/ARA版Q2_K |
| 動作モード | think=false/think=true |
| 出力上限 | num_predict=4096 |
| 文脈容量 | num_ctx=8192 |
| 生成設定 | temperature=0、seed=42 |
| 処理の期限 | 1件300秒の全体期限、通信読み取り120秒 |
| 実行回数 | 各条件1回、失敗を成功した再試行で置換しない |
この試験は、先行結果を見た後に設計した出力上限の感度確認です。最初から独立に用意した標準ではありません。また、出力上限を増やすために処理の期限も変更しています。期限が効いた回答があれば、その改善をトークン数だけの効果と断定せず、停止理由も一緒に示します。試行順序を変えても、各条件1回という制約は残ります。
| 条件 | 上限1,024 | 上限4,096 | 増えた正答 | 20問の回答時間合計 |
|---|---|---|---|---|
| ARA版・通常 | 11/20 | 11/20 | 0問 | 1.3分 → 1.3分 |
| 原版側・通常 | 10/20 | 10/20 | 0問 | 1.6分 → 4.0分 |
| ARA版・思考あり | 11/20 | 12/20 | 1問 | 10.6分 → 19.1分 |
| 原版側・思考あり | 15/20 | 17/20 | 2問 | 10.2分 → 17.1分 |
ARA版で正答へ変わったのは、容量10の箱へ大きさ8・7・6・5・4の荷物を分割せず入れる問題です。最少は4箱で、8、7、6+4、5と分けられます。1,024トークンでは回答前に切れましたが、拡大後は1,923トークンを使って「4」で終了しました。原版側ではこの箱詰め問題と、長い会議メモの訂正を反映し、指定担当者の決定済み議題IDを抽出する問題が改善しました。会議メモは2,048トークンで正答を完了しています。
ARA版の上限停止は6件から3件へ減りましたが、3問解けるようになったわけではありません。箱詰めの1問が回復し、費用の上限内で候補を選ぶ問題と、値を順に取り出すコードを読む問題は、上限停止から反復エラーへ移りました。以前の上限で見えなかった停止理由が現れた形です。正解へ変わった件数と、終了理由だけが変わった件数を分けて扱います。
| 思考あり・上限4,096 | 正常終了して正答 | 上限で停止 | 反復エラー | 時間切れ |
|---|---|---|---|---|
| ARA版 | 12件 | 3件 | 5件 | 0件 |
| 原版側 | 17件 | 2件 | 1件 | 0件 |
思考ありの所要時間の中央値は、ARA版27.4→27.3秒、原版側24.5→24.7秒でほぼ同じでした。それでも20問の合計はARA版10.6→19.1分、原版側10.2→17.1分へ増えています。一部の長い失敗が待ち時間を押し上げるため、中央値だけでは運用上の負担を見落とします。通常回答でも、原版側は正答数が変わらないまま合計1.6→4.0分になりました。
このモデルの良い点と、運用で困る点
良い点は、約11.9GBの配布ファイルで31Bモデルを手元で動かせることです。今回の推論は外部の生成サービスへ入力を送らず、ローカルで完結しました。これは原版側とARA版に共通する利点です。ARA版は通常モードの選択20問で11問に正答し、その中の情報抽出4問はすべて完了して正答しました。ただし、より広い通常モード60問では両モデルとも33/60で、ARA版が全般に優れているとは言えません。
思考モードにも使いどころはあります。上限4,096のARA版を通常モードと問題ごとに比べると、選択した計算4問を含む6問が正答へ変わりました。一方、通常モードで正答した5問が未完了へ変わり、合計では11/20から12/20への改善にとどまります。「考えさせれば常によくなる」設定ではありません。
| 観点 | 今回見えた良い点 | 注意点 |
|---|---|---|
| 回答の質 | 思考ありで完了した回答は両モデルとも全件正答 | 全20問を分母にするとARA版12/20、原版側17/20 |
| 通常モード | 選択20問のARA版は11/20、原版側は10/20 | 1問差・各条件1回。通常60問では同点 |
| 思考モード | 上限拡大でARA版1問、原版側2問が回復 | ARA版8問、原版側3問が未完了のまま |
| 速度と容量 | 同条件の生成速度とモデル用メモリ計上は同程度 | 改変版による明確な高速化・省メモリ化は確認していない |
| 拒答の低減 | ARA版の改変目的として上流が説明 | 本試験では測っておらず、実証した長所には数えない |
弱点として目立ったのは、ARA版の反復と回答の未完了です。もっとも、今回だけで原因をARA処理へ一つに絞ることはできません。低いビット数の量子化、元の重み、実行ソフト、思考の読み分けなどが関わり得ます。別の量子化や実行ソフトとの対照試験は行っていないため、Q2_Kが原因とも、改変だけが原因とも断定しません。
このMacのスペックがネックなのか
検証機はApple M2 Ultra、24コアの、60コアの、メモリ192です。実機の情報を記録し、チップ構成はAppleの仕様資料とも照合しました。実行ログでは61/61層がGPUへ配置されていました。CPUだけでモデルを処理していたわけではありません。
メモリ容量が今回の失敗を起こした兆候はありません。文脈8,192でのOllamaのモデル用メモリ計上は両モデルとも約13.03GiBで、追加診断中の確認では、の使用量も0でした。主比較80試行の時間切れは0件で、記録された7件のエラーはすべて反復停止でした。ただし、約13.03GiBは実行系が返すモデル単位の計上値です。Mac全体の使用量や、処理中の最大値を測った数字ではありません。
速度は使い勝手の制約になります。256トークンを生成する先行の速度試験を各モデル3回行った中央値は、ARA版23.02、原版側22.69トークン/秒でした。約23トークン/秒なら4,096トークンの生成だけで約178秒かかる計算です。実際、主比較で4,096の上限に達した6試行は約187〜203秒かかりました。数分の待ち時間が許容できない用途では、この構成とモデルの組み合わせは重く感じられます。
したがって、今回の証拠から言えるのは「メモリ不足の兆候はなく、長い生成の待ち時間は大きい」というところまでです。GPUの計算、メモリ転送、ディスクのどれが速度を制限しているかは、連続的な負荷測定や他機種との比較をしていないため特定できません。確認時には温度や性能に関する警告記録はありませんでしたが、検証全体で発熱による速度低下がなかったことを保証する観測ではありません。
Macを買い替えれば今回の反復や誤答まで直る、という結果ではありません。高速な機材なら同じ生成量の待ち時間を短くできる可能性がありますが、指定したトークン上限や反復停止の仕組みは別です。品質の原因をさらに切り分けるなら、このMacで高いビット数の量子化版を比較し、その後に実行ソフトや機種を変える順序が合理的です。今回はそこまでの追試は行っていません。
「上限停止」「反復停止」「時間切れ」は別に数える
記録には最終回答だけでなく、終了理由、エラー、使用トークン数、経過時間も残します。done_reason=lengthなら指定された生成枠などの制限で止まった可能性を調べます。最終回答が空でも、思考が続いた末に上限へ達したのか、通信自体が失敗したのかで対処が変わります。出力の一部が正解と一致していても、正常終了していなければ成功扱いにはしません。 ここで正常完了は、エラーがなく、done=trueかつdone_reason=stopを確認した状態です。内容が正しいことは、別に採点します。
今回現れたprediction aborted, token repeat limit reachedは、による別の中断です。固定した版のcompletion経路では、前後の空白を除いた出力断片が連続して同じになるとカウンターが増え、100を超えるとエラーになります。これは1024や4096という生成上限ではありません。repeat_penaltyなどの繰り返しを減らす設定も、この固定判定を解除するスイッチとは異なります。該当ソース
時間も二つに分けます。一定時間データが届かない場合の通信待ちと、少しずつ届いていても開始から300秒で打ち切るは別です。長い思考へ十分な時間を渡しながら、終わらない反復を待ち続けないため、追加試験は全体の期限を持たせています。期限切れは未完了として数え、モデルが自分で回答を終えたことにはしません。
num_predict=-1も、この版では完全な無制限ではない
Ollamaの設定資料はnum_predict=-1を無限生成と説明しています。しかし、今回の0.40.0のboundedNumPredict()は、負数または過大な指定を10 × num_ctxへ丸めます。文脈8192なら81,920トークンです。この上限まで必ず生成するという意味ではなく、それより前に通常の終了や別の停止条件が働くこともあります。固定コミットの処理
さらに、を使って続行しても、過去の情報をすべて保持できるわけではありません。古い文脈の一部を捨てて空きを作ります。Ollamaが使う側の文脈を移動する実装でも、その削除が確認できます。長い生成を許す設定と、長い資料を正確に覚える能力を同じものとして説明しないことが大切です。
さらに、主比較で上限停止と反復エラーが出た問題から、事前に固定した規則で2問を選び、両モデルへ追加診断を行いました。num_predict=-1、文脈16,384、全体期限600秒へ変更しています。出力上限だけを変えた比較ではなく、主20問の成績とは分けて扱います。
| 追加診断の対象 | ARA版 | 原版側 |
|---|---|---|
| 長い在庫表から条件に合う品番を抽出 | 600秒で時間切れ | 600秒で時間切れ |
| 費用の上限内で候補を選択 | 約91秒で反復エラー | 約119秒で反復エラー |
在庫表の試行では、生成途中のサーバーログからARA版で少なくとも7,502、原版側で少なくとも10,593トークンの生成を確認しました。4,096を超えたことは確認できましたが、記号や数字の反復が続き、回答には到達していません。この数字は途中観測の下限で、最終的な使用量ではありません。時間切れや反復エラーでは、最終の使用量が返らないためです。
設定で小さな出力上限を緩めることはできます。ただし、今回の2問ではそれだけで問題は解決しませんでした。長い回答が必要なら上限と待ち時間を増やす価値がありますが、反復が始まった回答を無制限に待つ運用にはしません。文脈容量、反復停止、利用側の時間制限をそれぞれ扱う必要があります。
1件の応答を保存してから、終了状態を集計する
以下はでローカルのへ1件だけ送り、応答をファイルに残す例です。検証用サーバーを127.0.0.1の11437番で起動し、記事と同じ名前のモデルを登録済みであることが前提です。1件の確認では保存しやすい非ストリーミング応答を使っています。比較本体は逐次応答を保存する方式であり、この短い例だけで20問の試験を再現したことにはなりません。 通信失敗や時間切れでは保存ファイルが空や不完全になることがあるため、その場合は次の集計で入力エラーとして表示します。
curl --fail-with-body --silent --show-error \ --connect-timeout 5 --max-time 300 \ http://127.0.0.1:11437/api/chat \ --header 'Content-Type: application/json' \ --output response.json \ --data-binary @- <<'JSON'{ "model": "gemma4-31b-ara-q2k:latest", "messages": [ {"role": "system", "content": "指定した形式で答えてください。"}, {"role": "user", "content": "在庫40個から9個を出荷し、13個を入荷しました。現在の在庫を整数だけで答えてください。"} ], "think": true, "stream": false, "keep_alive": "10m", "options": { "num_ctx": 8192, "num_predict": 4096, "temperature": 0, "seed": 42 }}JSON次の例は、直前のresponse.json、または同梱のrecordsを持つ結果ファイルを読みます。正常完了、長さ制限、エラー、正答を別々に数えます。単発の応答ファイルには正解を照合した採点情報がないため、正答数を勝手に推定せず「採点なし」に数えます。正答の文字が本文に含まれるだけで合格にすると、反復や途中出力を成功へ混ぜてしまうためです。
python3 - response.json <<'PY'import jsonimport sysfrom pathlib import Path
for filename in sys.argv[1:]: try: data = json.loads(Path(filename).read_text(encoding="utf-8")) except (OSError, json.JSONDecodeError) as exc: print(json.dumps({"file": filename, "input_error": type(exc).__name__}, ensure_ascii=False)) continue records = data.get("first_records", data.get("records")) if records is None: records = [{"response": data}] if not isinstance(records, list): raise ValueError("records must be a list") counts = {"attempted": len(records), "completed": 0, "length_stop": 0, "errors": 0, "strict_correct": 0, "unscored": 0, "reported_generated_tokens": 0} for record in records: response = record.get("response") or record.get("final_packet") or record reason = record.get("done_reason") or response.get("done_reason") status = record.get("status", "error" if response.get("error") else "ok") done = response.get("done", status == "ok" and reason is not None) failed = status != "ok" or bool(record.get("error") or response.get("error")) completed = bool(done) and not failed and reason == "stop" strict = record.get("score", {}).get("strict_output_passed") counts["completed"] += int(completed) counts["length_stop"] += int(reason == "length") counts["errors"] += int(failed) counts["strict_correct"] += int(completed and strict is True) counts["unscored"] += int(strict is None) metrics = record.get("metrics", {}) tokens = metrics.get("eval_count", response.get("eval_count")) counts["reported_generated_tokens"] += int(tokens or 0) print(json.dumps({"file": filename, **counts}, ensure_ascii=False))PYreported_generated_tokensは、実行系から取得できた値だけの合計です。途中でエラーになった記録では最終の使用量が返らない場合があるため、ゼロや欠測を「計算していない」と解釈しないでください。また、先行試験との比較には、全件を集計する前に同じ20個の問題IDへそろえる必要があります。ファイル名が似ていることだけで、分母まで同じとは判断できません。
点数と一緒に、答えを届けられた割合を残す
今回の採点は、指定された文字列やJSONの値、キーの過不足、配列の順序を確認します。JSONの数値1と1.0は同値とし、trueと1は別物として扱います。JSONを求めた問題で説明文やコードフェンスが付けば、厳格採点では不正解です。二次採点は回答全体を囲む1組のフェンスだけを外し、説明文は取り除きません。本文が意味的に近いだけの回答や、構文だけ正しいが値が違う回答を、正解と混同しないためです。
速度にも同じ注意が必要です。思考が始まるまでの時間と、利用者が読む最終回答が現れるまでの時間は異なります。反復して大量のトークンを出せば、生成速度の数字だけは得られても、仕事は終わりません。実務で選ぶ際は、正答数に加えて正常完了率、最初の回答までの待ち時間、全体の時間を確認すると、使い勝手へ結び付けやすくなります。
今回の20問では、出力上限4,096の思考ありは原版側17/20、ARA版12/20でした。原版側だけが正答した問題は5問、ARA版だけが正答した問題は0問です。長めの回答時間を許容できるこの条件では、原版側を選ぶ判断になります。ただし、自作の架空課題・各条件1回の比較です。日本語全般の能力、量子化前の品質、拒答低減の効果、他の実行環境での速度まで示す結果ではありません。
問題・条件・結果・再集計コードをまとめた検証資料から、同じ条件を追えるようにします。モデル本体は同梱せず、取得元と版を明示します。ここまでで確認したいのは、点数を付ける前に停止の理由を残すことです。続編は読者のリアクションに応じて、別の量子化や実際の業務課題へ広げていきます。